一块 RK3576 板子,6 TOPS 的 NPU,能不能让系统自己听懂「把亮度调到 150」?
这篇文章不讲训练,也不讲调参,只讲一件事:从 BSP 编译到 SystemUI 聊天卡片,一句话是怎么走到 NPU,又怎么变成一次真实的设备操作的。
00 先看整体:一条链路,三个问题
先给结论。整套方案可以概括成一句话:
把一个 3B 的 Qwen2.5 模型、RKLLM 运行时、一个 Native 常驻服务,全部打包进 vendor 模块,向上只暴露一个 127.0.0.1:8080 的 OpenAI 兼容 HTTP 接口;SystemUI 里的聊天卡片通过 SSE 流式读取大模型输出,把其中的 <tool_call> 文本解析成白名单里的设备动作。
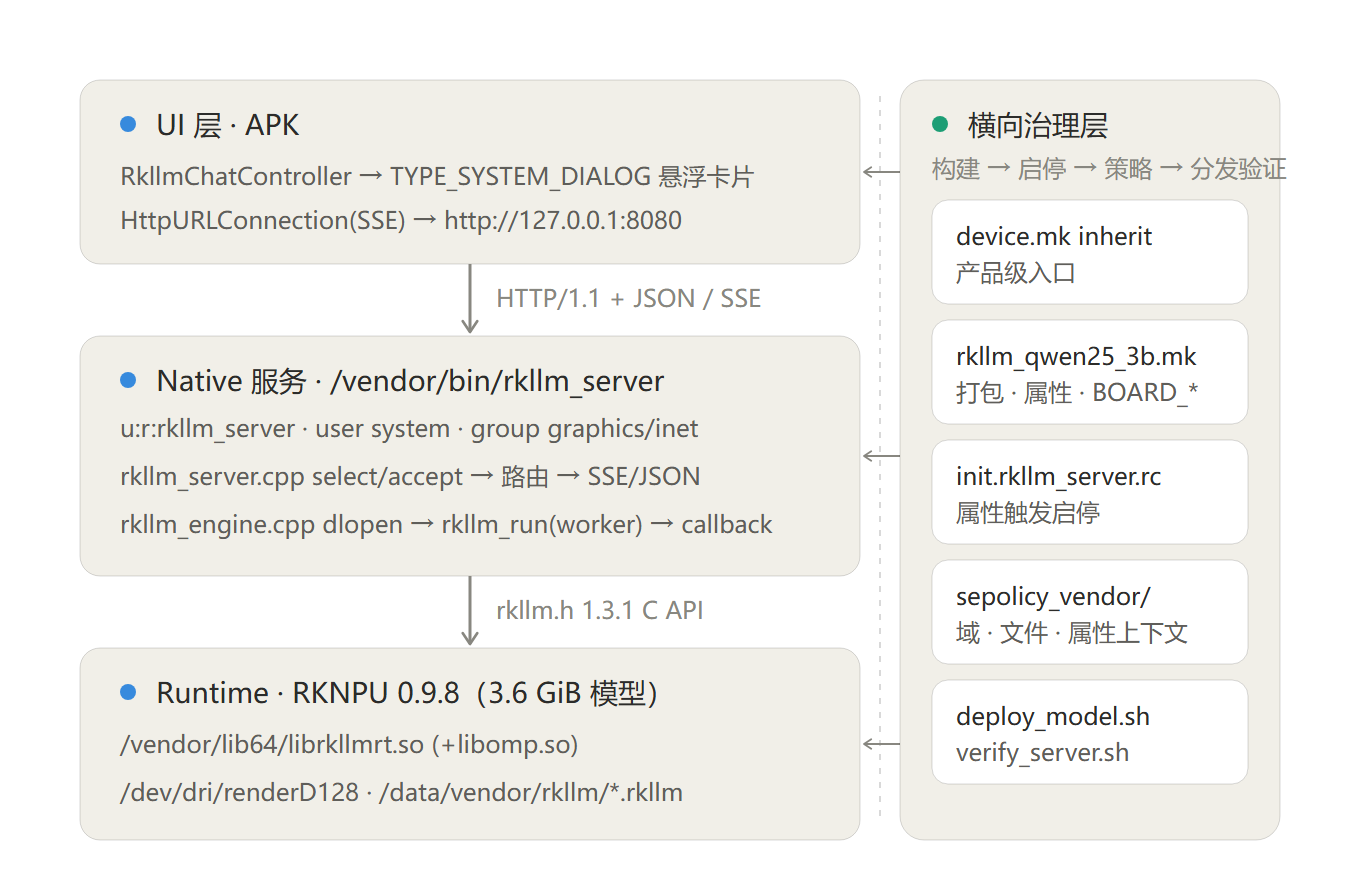
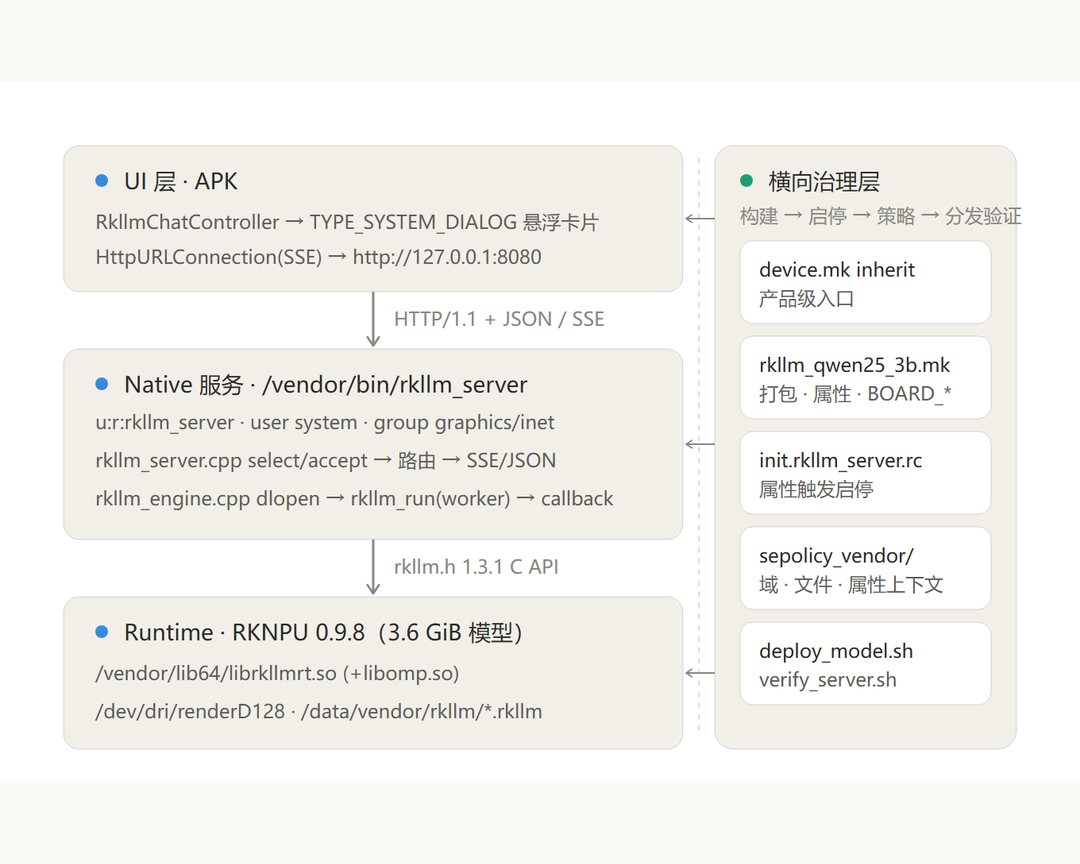
这张图从上到下是三层主链路,右侧是贯穿始终的「横向治理层」:
| 层 | 位置 | 职责 |
|---|---|---|
| UI 层 | SystemUI 的 RkllmChatController |
悬浮卡片收发消息,用 HttpURLConnection 读 SSE |
| Native 服务 | /vendor/bin/rkllm_server |
起 socket、做路由、把 C API 包成 HTTP 接口 |
| Runtime | librkllmrt.so + RKNPU |
真正跑模型,加载 3.6 GiB 的 .rkllm 模型 |
| 横向治理 | device.mk / .mk / .rc / sepolicy / 部署脚本 |
编译集成、属性启停、SELinux 域、模型分发 |
本文依次回答三个问题:
- 模型怎么被「编进系统」而不是装成一个 App?
- 一个手搓的 HTTP 服务怎么把 OpenAI 格式的请求翻译成
rkllm_run? - 模型输出的一段纯文本,怎么安全地变成一次设备操作?
说明:本文聚焦框架与调用链,性能测试数据(首 token 延迟、token/s、内存占用)另文整理。
01 第一步:让模型「进系统」
本节回答:BSP 侧到底改了什么。
1.1 一个 vendor 模块装下全部家当
vendor/rockchip/common/rkllm_qwen25_3b/ 是整套方案的「供给端资产包」,把四类东西集中在一起:
| 目录/文件 | 内容 |
|---|---|
prebuilt/arm64-v8a/ |
运行时 librkllmrt.so、libomp.so、llm_demo,RK 提供,是推理引擎与 C API 契约 |
server/ |
服务实现:dlopen 运行时、后台加载模型、rkllm_run 推理、LLMResultCallback 流式输出 |
init.rkllm_server.rc / sepolicy_vendor/ |
服务启停、SELinux 域与文件上下文 |
rkllm_qwen25_3b.mk |
构建/部署/权限配置,供产品级 inherit-product 一行继承 |
对外只保留三个路由:GET /v1/models、GET /healthz、POST /v1/chat/completions。
顺带一提:服务其实不一定要放在 BSP 里。把
RKLLM的 so 库集成进 APK 也是可行路径,只是少了系统属性启停、SELinux 域和产品级打包这些「系统身份」带来的便利。
1.2 编译集成:一行 inherit-product
在 device/rockchip/rk3576/device.mk 里挂上模块:
$(call inherit-product, vendor/rockchip/common/rkllm_qwen25_3b/rkllm_qwen25_3b.mk)1.3 mk 文件:拷什么,不拷什么
# RKLLM Qwen2.5-3B service integration for RK3576 / Android 14.
# Inherited by device/rockchip/rk3576/device.mk.

RKLLM_QWEN25_DIR := vendor/rockchip/common/rkllm_qwen25_3b

PRODUCT_COPY_FILES += \
    $(RKLLM_QWEN25_DIR)/prebuilt/arm64-v8a/librkllmrt.so:$(TARGET_COPY_OUT_VENDOR)/lib64/librkllmrt.so \
    $(RKLLM_QWEN25_DIR)/prebuilt/arm64-v8a/libomp.so:$(TARGET_COPY_OUT_VENDOR)/lib64/libomp.so \
    $(RKLLM_QWEN25_DIR)/prebuilt/arm64-v8a/llm_demo:$(TARGET_COPY_OUT_VENDOR)/bin/llm_demo \
    $(RKLLM_QWEN25_DIR)/tools/fix_freq_rk3576.sh:$(TARGET_COPY_OUT_VENDOR)/bin/fix_freq_rk3576.sh \
    $(RKLLM_QWEN25_DIR)/init.rkllm_server.rc:$(TARGET_COPY_OUT_VENDOR)/etc/init/init.rkllm_server.rc

PRODUCT_VENDOR_PROPERTIES += \
    persist.vendor.rkllm.server.enable=0 \
    vendor.rkllm.model_path=/data/vendor/rkllm/Qwen2.5-3B-Instruct_W8A8_RK3576.rkllm

# The service resolves librkllmrt.so with dlopen(); the prebuilt libraries
# above are installed by PRODUCT_COPY_FILES, not linked at build time.
PRODUCT_PACKAGES += rkllm_server

# The model is about 3.6 GiB and must NOT be copied into system/vendor images.
# Deploy it to /data/vendor/rkllm/ at first boot or via OTA instead.
BOARD_VENDORIMAGE_PARTITION_SIZE := 402653184
BOARD_SEPOLICY_DIRS += $(RKLLM_QWEN25_DIR)/sepolicy_vendor
三个关键点:
- 运行时是「拷进去」而不是「链进去」。服务用
dlopen()找librkllmrt.so,编译期不链接,所以PRODUCT_PACKAGES里只有rkllm_server。 - 模型不进镜像。3.6 GiB 的模型靠首次启动或 OTA 放到
/data/vendor/rkllm/。 BOARD_VENDORIMAGE_PARTITION_SIZE调到 384 MiB(402653184 字节)。全量编译实测约 343565158 字节,留出约 59 MiB 余量;super 动态分区组仍有约 1 GiB 空闲,不需要改 GPT,但super.img必须整包重编重刷。
1.4 服务怎么被拉起
init.rkllm_server.rc 把服务定义成默认关闭、由属性触发:
# RKLLM OpenAI-compatible HTTP service.
# Disabled by default. Enable it with:
#   setprop persist.vendor.rkllm.server.enable 1

service rkllm_server /vendor/bin/rkllm_server \
    --model /data/vendor/rkllm/Qwen2.5-3B-Instruct_W8A8_RK3576.rkllm \
    --library /vendor/lib64/librkllmrt.so \
    --bind 127.0.0.1 --port 8080
    class main
    user system
    group system graphics inet
    seclabel u:r:rkllm_server:s0
    disabled

on property:persist.vendor.rkllm.server.enable=1
    start rkllm_server

on property:persist.vendor.rkllm.server.enable=0
    stop rkllm_server
只绑定 127.0.0.1,意味着这个接口只对本机开放,外部网络访问不到。调试时把模型和开关推上去即可:
adb root
# 模型放到 /data/vendor/rkllm/,与 mk 里的 vendor.rkllm.model_path 保持一致
adb push Qwen2.5-3B-Instruct_W8A8_RK3576.rkllm \
    /data/vendor/rkllm/Qwen2.5-3B-Instruct_W8A8_RK3576.rkllm

setprop persist.vendor.rkllm.server.enable 1
若模型要随源码一起管理,则放到 vendor/rockchip/common/rkllm_qwen25_3b/prebuilt/model/:
git checkout QY-R3576-DEL
mkdir -p vendor/rockchip/common/rkllm_qwen25_3b/prebuilt/model
mv out/rkllm_model_backup/Qwen2.5-3B-Instruct_W8A8_RK3576.rkllm \
   vendor/rockchip/common/rkllm_qwen25_3b/prebuilt/model/
02 第二步:一个手搓的 OpenAI 兼容 HTTP 服务
本节回答:一个 HTTP 请求怎么被翻译成一次 NPU 推理。
2.1 主循环:socket + select
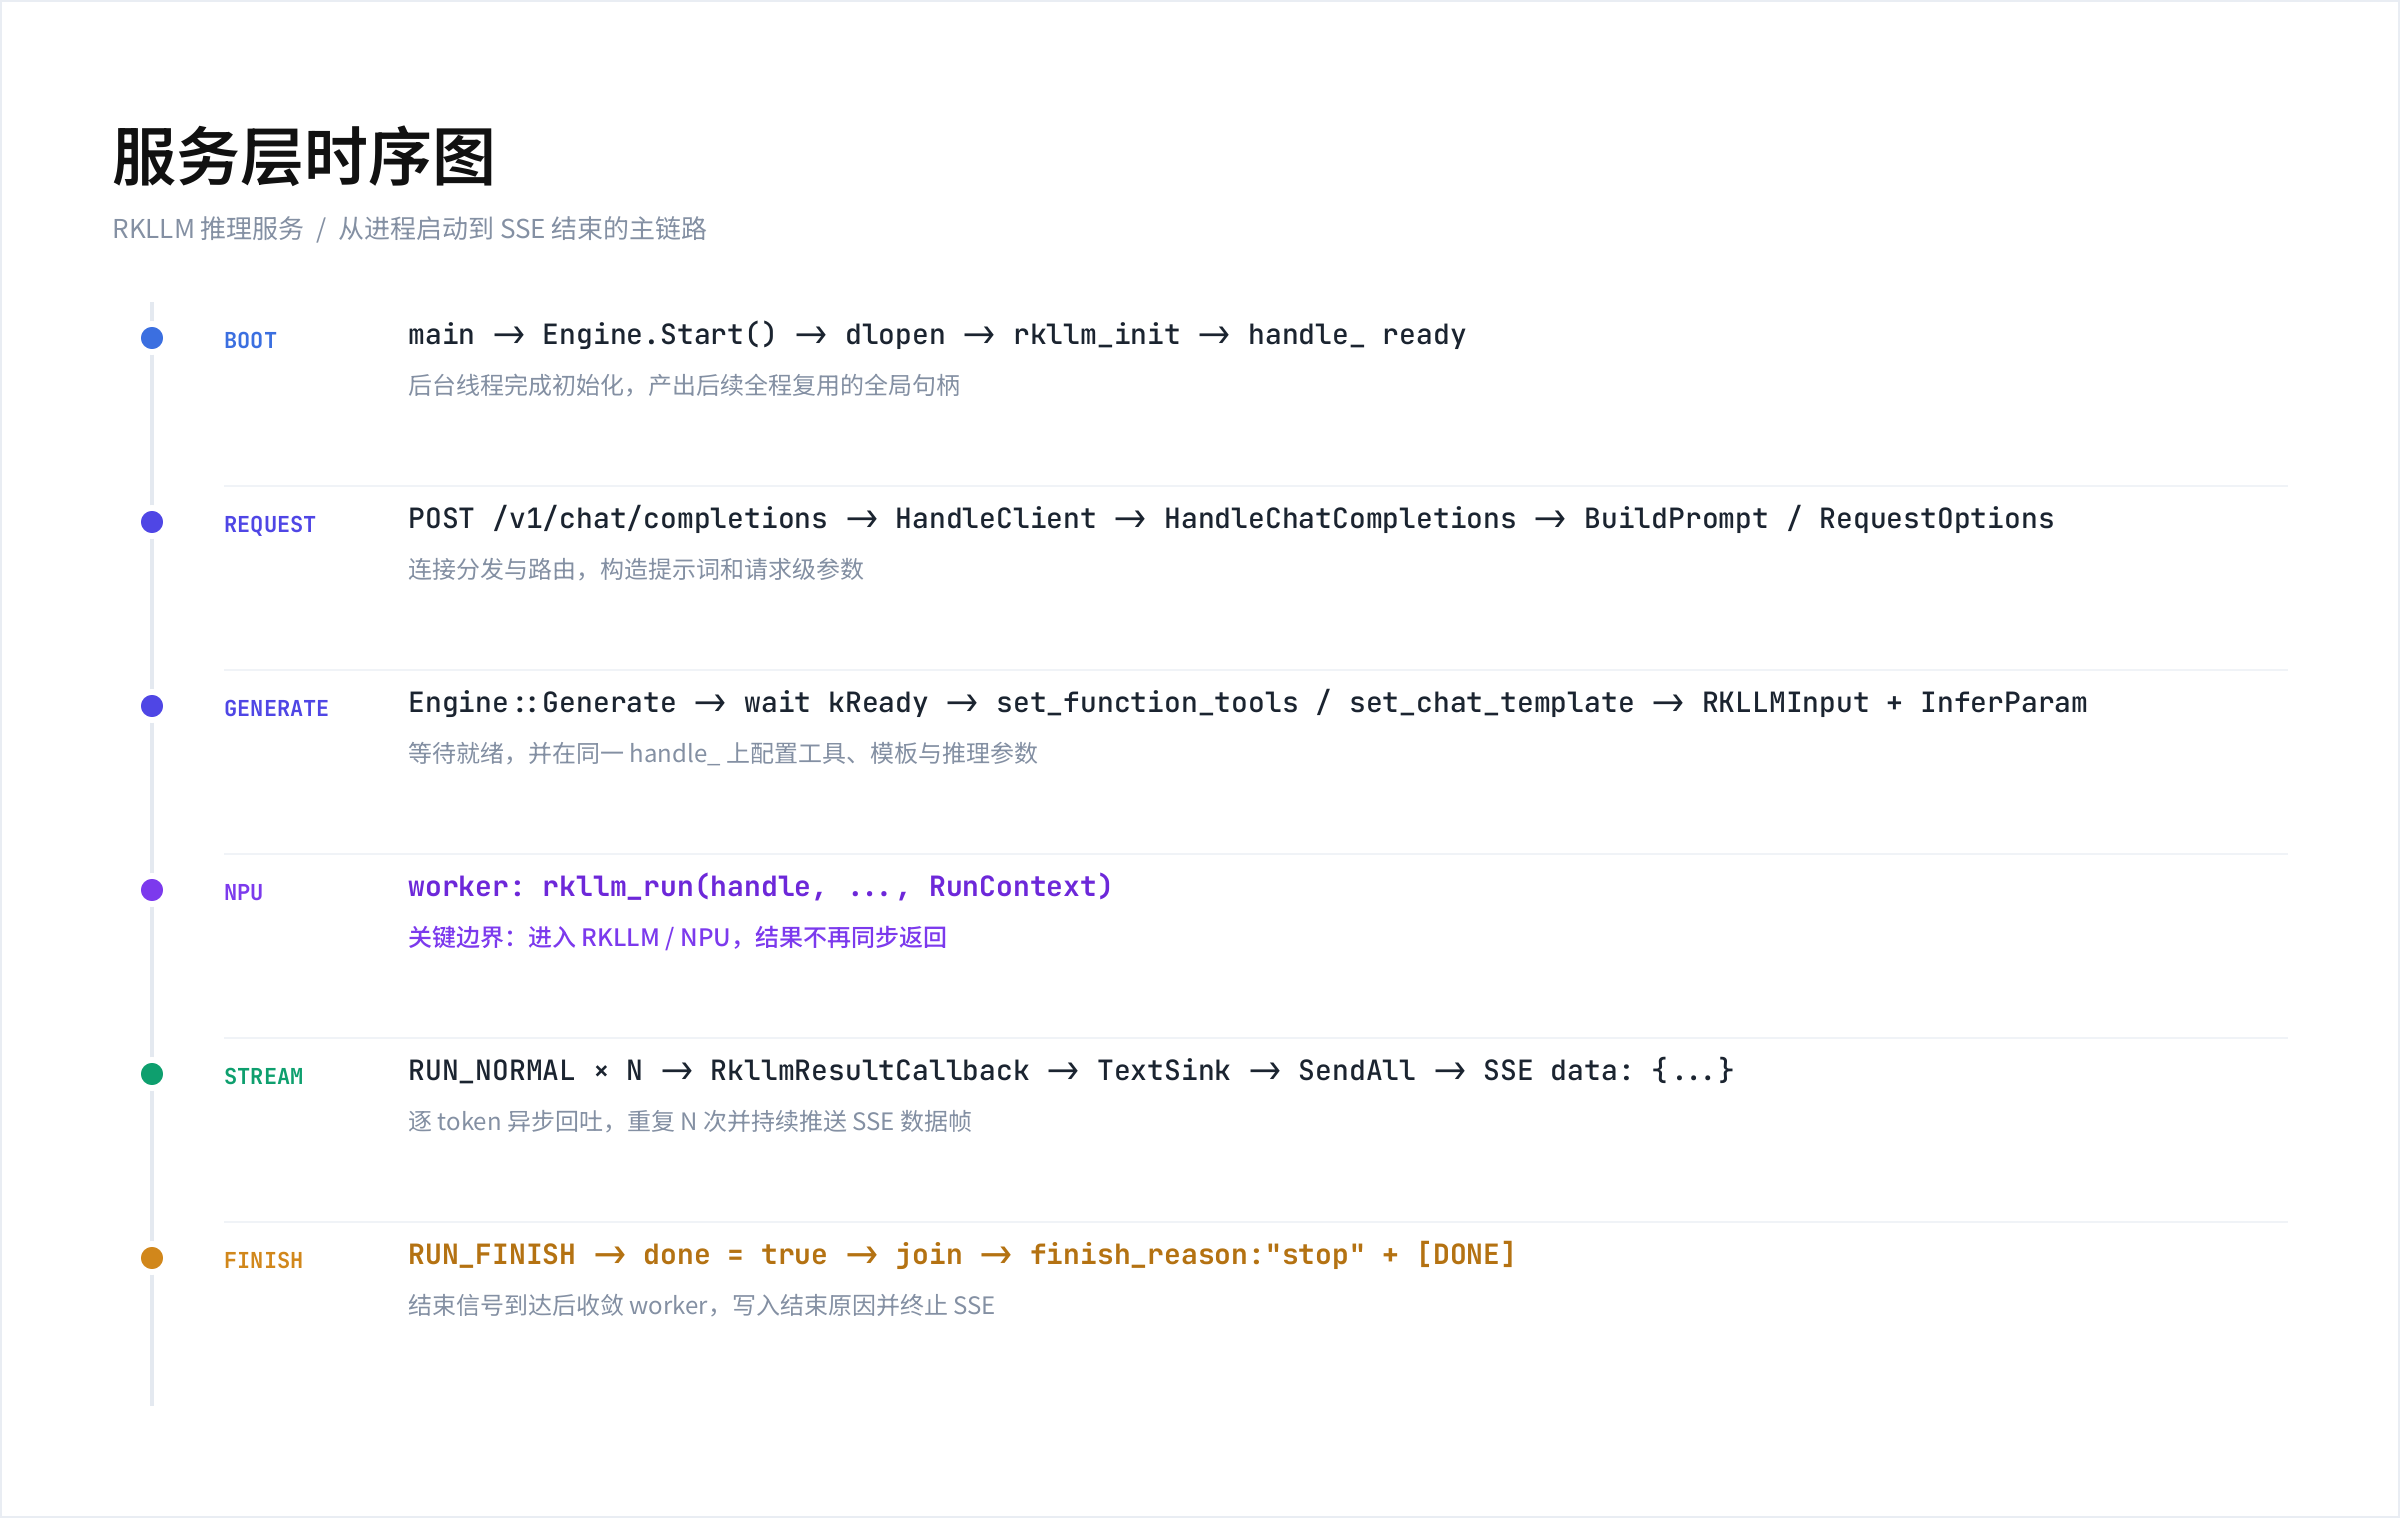
服务没有用现成的 HTTP 库,而是自己起了个 socket,用 select() 做超时轮询,一次接一个客户端。这是单线程模型,后面第 06 节会讨论它的代价。
int RunServer(rkllm::Engine* engine, const std::string& bind_ip, int port,
              const std::string& model) {
    const int listen_fd = socket(AF_INET, SOCK_STREAM, 0);
    int reuse = 1;
    setsockopt(listen_fd, SOL_SOCKET, SO_REUSEADDR, &reuse, sizeof(reuse));

    struct sockaddr_in address = {};
    address.sin_family = AF_INET;
    address.sin_port = htons(static_cast<uint16_t>(port));
    if (inet_pton(AF_INET, bind_ip.c_str(), &address.sin_addr) != 1) {
        ALOGE("invalid bind address: %s", bind_ip.c_str());
        close(listen_fd);
        return 1;
    }
    if (bind(listen_fd, reinterpret_cast<struct sockaddr*>(&address), sizeof(address)) < 0) {
        ALOGE("bind(%s:%d) failed: %s", bind_ip.c_str(), port, strerror(errno));
        close(listen_fd);
        return 1;
    }
    if (listen(listen_fd, 8) < 0) {
        ALOGE("listen() failed: %s", strerror(errno));
        close(listen_fd);
        return 1;
    }

    while (g_stop == 0) {
        fd_set fds;
        FD_ZERO(&fds);
        FD_SET(listen_fd, &fds);
        struct timeval timeout = {1, 0};   // 每秒醒一次,好响应退出信号
        const int ready = select(listen_fd + 1, &fds, nullptr, nullptr, &timeout);
        if (ready <= 0) {
            continue;
        }
        const int client_fd = accept(listen_fd, nullptr, nullptr);
        if (client_fd < 0) {
            continue;
        }
        HandleClient(client_fd, engine, model);
        close(client_fd);
    }
    close(listen_fd);
    return 0;
}
2.2 路由表:三个入口
void HandleClient(int fd, rkllm::Engine* engine, const std::string& model) {
    struct timeval receive_timeout = {10, 0};  // 读请求 10 秒没数据就放弃
    struct timeval send_timeout = {60, 0};    // 单次 send() 阻塞超 60 秒判失败
    setsockopt(fd, SOL_SOCKET, SO_RCVTIMEO, &receive_timeout, sizeof(receive_timeout));
    setsockopt(fd, SOL_SOCKET, SO_SNDTIMEO, &send_timeout, sizeof(send_timeout));

    HttpRequest request;
    if (!ReadHttpRequest(fd, &request)) {
        return;
    }
    if (request.method == "GET" && request.path == "/v1/models") {
        SendJson(fd, 200, "OK", BuildModels(model));
    } else if (request.method == "GET" &&
               (request.path == "/healthz" || request.path == "/")) {
        // 判断设备是否就绪、是否忙碌
        SendJson(fd, 200, "OK", BuildHealth(*engine, model));
    } else if (request.method == "POST" && request.path == "/v1/chat/completions") {
        HandleChatCompletions(fd, request, engine, model);
    } else {
        SendJson(fd, 404, "Not Found", BuildError("Unknown endpoint.", "invalid_request_error"));
    }
}
2.3 请求分发:参数、工具与两种输出模式
HandleChatCompletions() 把 OpenAI 风格的 JSON 字段映射到 runtime 参数,并把 tools 定义原样交给 runtime:
// 节选:参数映射 + 工具透传
options.top_k               = GetInt(root,   "top_k", 1, 1, 100);
options.top_p               = GetFloat(root, "top_p", 0.9f, 0.0f, 1.0f);
options.temperature         = GetFloat(root, "temperature", 0.8f, 0.0f, 2.0f);
options.max_tokens          = GetInt(root,   "max_tokens", 512, 1, 4096);
options.enable_thinking     = GetBool(root, "enable_thinking", false);

const Json::Value& tools = root["tools"];
if (tools.isArray() && !tools.empty()) {
    Json::StreamWriterBuilder writer;
    writer["indentation"] = "";
    options.tools = Json::writeString(writer, tools);
}

const std::string id = CompletionId();
const bool stream = GetBool(root, "stream", false);

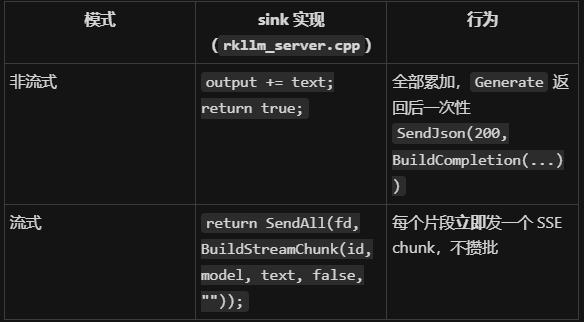
if (!stream) {
    std::string output;
    const rkllm::TextSink sink = [&output](const std::string& text) {
        output += text;
        return true;
    };
    const rkllm::Status status = engine->Generate(prompt, role, options, sink, &error);
    // 此处省略:把 output 组装成 OpenAI 格式的 JSON 响应并 SendJson 回客户端
    return;
}
// ... 以下为流式分支,见 3.6 节这里要分清两个「4096」:max_context_len = max_new_tokens = 4096 是模型加载时的上下文上限(必须等于模型导出的 max_context_limit),而 max_tokens 是每次请求允许生成的长度,默认值 512、上限 4096。两者不是一回事。
流式分支则先发 SSE 头,再用同一个 Generate() 逐片段推送:
SendSseHeaders(fd);
SendAll(fd, BuildStreamChunk(id, model, "", true, ""));

const rkllm::TextSink sink = [fd, &id, &model](const std::string& text) {
    return SendAll(fd, BuildStreamChunk(id, model, text, false, ""));
};
const rkllm::Status status = engine->Generate(prompt, role, options, sink, &error);
if (status == rkllm::Status::kOk) {
    SendAll(fd, BuildStreamChunk(id, model, "", false, "stop"));
    SendAll(fd, "data: [DONE]\n\n");
} else {
    // 响应头已发出,只能把失败作为 SSE 事件写进流里
    SendAll(fd, "data: " + BuildError(error, "server_error") + "\n\n");
    SendAll(fd, "data: [DONE]\n\n");
}设计上最讨巧的一点:非流式和流式复用同一个
Generate(),区别只在TextSink的实现——一个是往字符串里累加,一个是往 socket 里写。
03 第三步:Engine 层把 C API 包成可复用的引擎
本节回答:dlopen 之后到底发生了什么,以及工具定义是怎么「记住」的。
3.1 后台加载,不阻塞启动
void Engine::Start() {
{
std::lock_guard<std::mutex> lock(mutex_);
load_state_ = LoadState::kLoading;
}
loader_ = std::thread(&Engine::LoadModel, this); // 加载放到后台线程
}
void Engine::LoadModel() {
ALOGI("loading runtime %s and model %s",
library_path_.c_str(), model_path_.c_str());
bool ok = LoadRuntime();
LLMHandle handle = nullptr;
if (ok) {
RKLLMParam param = create_default_param_();
// 关键参数:
// max_context_len = max_new_tokens = 4096(须等于模型 max_context_limit)
// is_async = false;n_batch = 1;embed_flash = 1
// enabled_cpus_mask 绑定 CPU4~CPU7
callback_.result_callback = &RkllmResultCallback;
int rc = init_(&handle, ¶m, &callback_);
if (rc != 0) {
ALOGE("rkllm_init failed: %d", rc);
ok = false;
}
}
}3.2 dlopen 逐个解析符号
LoadRuntime() 负责把 librkllmrt.so 装进进程,把需要的 C API 逐个解析成强类型函数指针:
bool Engine::LoadRuntime() {
    library_ = dlopen(library_path_.c_str(), RTLD_NOW | RTLD_LOCAL);
    if (library_ == nullptr) {
        ALOGE("dlopen(%s) failed: %s", library_path_.c_str(), dlerror());
        return false;
    }
    const bool core_ok =
            ResolveSymbol(library_, "rkllm_createDefaultParam", &create_default_param_) &&
            ResolveSymbol(library_, "rkllm_init", &init_) &&
            ResolveSymbol(library_, "rkllm_run", &run_) &&
            ResolveSymbol(library_, "rkllm_abort", &abort_) &&
            ResolveSymbol(library_, "rkllm_destroy", &destroy_) &&
            ResolveSymbol(library_, "rkllm_set_function_tools", &set_function_tools_);
    // 可选:普通聊天时用来清掉工具配置
    ResolveSymbol(library_, "rkllm_set_chat_template", &set_chat_template_);
    return core_ok;
}
3.3 工具定义挂在 handle 上,会「记住」
rkllm_set_function_tools() 的配置是挂在模型实例 handle 上的、持久的。这带来一个必须处理的分支状态机:
// 节选:工具配置的切换逻辑
if (options.tools.empty()) {
    if (tools_configured_) {
        // 本次是普通问答:先恢复纯聊天模板,
        // 否则上一轮的工具定义会污染这一轮的回答
        const int trc = set_chat_template_(handle, nullptr, nullptr, nullptr);
        if (trc == 0) {
            tools_configured_ = false;
            applied_tools_.clear();
        }
    }
} else if (options.tools != applied_tools_) {
    // 工具定义有变化才重新注册,避免重复设置
    const int trc = set_function_tools_(handle, kDefaultToolSystemPrompt,
                                        options.tools.c_str(), kToolCallTag);
    if (trc != 0) {
        ALOGE("rkllm_set_function_tools failed: %d", trc);
        *error = "rkllm_set_function_tools failed";
        return Status::kError;
    }
    applied_tools_ = options.tools;
    tools_configured_ = true;
}
四个参数的含义:
| 参数 | 作用 |
|---|---|
handle |
rkllm_init 得到的句柄,配置挂在模型实例上,持久生效 |
system_prompt |
固定提示词:仅当用户明确要求设备操作才调用函数;其它问题直接回答且不提及工具;收到工具结果后简短说明成败 |
tools |
紧凑 JSON 字符串,runtime 把它注入聊天模板,让模型知道有哪些函数、参数 schema 是什么 |
tool_response_str |
tokenizer 用来把「工具输出」识别成独立对话轮的标记 |
3.4 Generate() 的六个参数
Status Engine::Generate(const std::string& prompt, const std::string& role,
                        const RequestOptions& options, const TextSink& sink,
std::string* error)| 参数 | 说明 |
|---|---|
prompt |
HTTP 层 BuildPrompt 的产物,单个字符串承载全部上下文(keep_history = 0);用 const 引用避免长文本拷贝 |
role |
最后一条 user / tool 消息的 role,直接填进 RKLLMInput.role |
options |
把 HTTP JSON 与 runtime 参数解耦 |
sink |
std::function<bool(const std::string&)>,唯一的输出抽象,逐片段推送;返回 false 表示对端已断开,会驱动 rkllm_abort |
error |
C 风格输出指针,失败时写原因,HTTP 层映射成 500/503 或 SSE 错误事件 |
| 返回值 | kOk / kBusy / kError 三态,与 error 构成「状态码 + 详情」双通道 |
3.5 同步 run、worker 线程与断连中止
rkllm_run() 是同步阻塞的,所以放到 worker 线程里跑,让请求线程留下来盯着客户端有没有断开:
// rkllm_run() is synchronous. Execute it on a worker thread so the
// request thread can keep watching for a disconnected HTTP client.
// rkllm_run_async() is not used because it requires param.is_async=1.
std::thread worker([&] {
    const int rc = run_(handle, &input, &infer, &context);
    if (rc != 0) {
        ALOGE("rkllm_run failed: %d", rc);
        context.failed.store(true);
    }
    context.done.store(true);
});

// 监视循环(伪代码):client_gone 由回调里 sink 返回 false 置位
while (!done && !stopping_) {
    cv_.wait_for(lock, 100ms);
    if (client_gone && !aborted) { unlock; abort_(handle); lock; aborted = true; }
}
abort_() 必须在解锁状态下调用,否则容易和回调抢锁造成死锁。
3.6 回调把 token 原样送出去
// C linkage is required by LLMResultCallback. The per-request context is
// passed as userdata to rkllm_run(), so no global state is involved.
extern "C" int RkllmResultCallback(RKLLMResult* result, void* userdata,
                                   LLMCallState state) {
    auto* context = static_cast<RunContext*>(userdata);
    if (context == nullptr) {
        return 0;
    }
    if (state == RKLLM_RUN_NORMAL) {
        if (result != nullptr && result->text != nullptr &&
            !context->client_gone.load()) {
            if (!(*context->sink)(std::string(result->text))) {
                context->client_gone.store(true);
            }
        }
    } else if (state == RKLLM_RUN_ERROR) {
        context->failed.store(true);
    }
    if (state == RKLLM_RUN_FINISH || state == RKLLM_RUN_ERROR) {
        context->done.store(true);
    }
    return 0;
}这里有个容易踩的坑:tool call 没有专用结构体。模型按 Qwen2.5 的格式生成一段纯文本,服务端完全不解析、不改写,原样透传:
<tool_call>{"name":"set_brightness","arguments":{"value":150}}</tool_call>链路是 RkllmResultCallback(RKLLM_RUN_NORMAL) → TextSink → BuildStreamChunk → SSE delta.content。拆分工作留给了上层。
补充:官方文档里
LLMResultCallback返回1可以暂停推理、注入新内容后再恢复,本文实现始终返回0,没有用到这个能力。另外RKLLMInput.role支持tool,所以工具执行结果可以回传给模型继续推理——这是第 04 节「两轮对话」的基础。
04 第四步:SystemUI 里,一句话怎么变成一次设备操作
本节回答:上层怎么判断意图、怎么解析输出、怎么保证不乱动设备。
代码位置:frameworks/base/packages/SystemUI/src/com/android/systemui/rkllm/RkllmChatController.java。
4.1 先判断意图,别把 11 个工具塞给每个问题
3B 模型很小,请求里一旦带上 11 个工具定义和工具系统提示词,它会把「今天天气怎么样」这类普通问题也套进「该不该调用工具」的框架里回答。所以发送前先做意图判断:
private void sendMessage() {
    final String text = mInput.getText().toString().trim();
    mExecutor.execute(() -> runConversation(text));
}
// 只有识别为设备操作时,第一轮请求才带工具定义
final boolean withTools = RkllmIntentRouter.isDeviceAction(mContext, text);4.2 工具清单长什么样
RkllmActionExecutor.buildToolsJson() 构建 OpenAI 风格的函数定义(共 11 个,此处节选前 4 个):
/** Keep descriptions short and imperative: a 3B model follows precise,
 *  unambiguous descriptions much better. */
public JSONArray buildToolsJson() {
    try {
        final JSONArray tools = new JSONArray();
        tools.put(function("open_app",
                "Open an installed app by package name",
                new String[]{"package", "string", "Package name of the app to open"}));
        tools.put(function("set_brightness",
                "Set the screen brightness",
                new String[]{"value", "integer", "Brightness level from 1 to 255"}));
        tools.put(function("set_volume",
                "Set the media volume",
                new String[]{"value", "integer", "Use the exact number the user "
                        + "asked for, do not convert it to a percentage"}));
        tools.put(function("open_settings",
                "Open the system settings app", null));
        // ... 其余:go_home / go_back / wifi_toggle / bluetooth_toggle /
        //     get_volume / get_battery / open_app_by_name
        return tools;
    } catch (JSONException e) {
        Slog.e(TAG, "failed to build tool definitions", e);
        return new JSONArray();   // 降级为不带工具调用
    }
}
描述写得短、用祈使句,是实测下来小模型最吃得消的写法。
4.3 两轮对话:执行 → 回传 → 总结
private void runConversation(String text) {
    final List<JSONObject> turns = new ArrayList<>();
    final JSONArray messages = new JSONArray();
    synchronized (mHistory) {
        for (JSONObject turn : mHistory) {
            messages.put(turn);       // 会话历史一起发过去
        }
    }
    messages.put(userMessage(text));
    turns.add(userMessage(text));

    final boolean withTools = RkllmIntentRouter.isDeviceAction(mContext, text);
    for (int round = 0; round < MAX_TOOL_ROUNDS; round++) {
        // 只有第一轮带工具定义
        final StreamBuffer buffer = request(messages, withTools && round == 0);
        final String spoken = buffer.displayText().trim();
        final List<String> calls = buffer.toolCalls();
        if (calls.isEmpty() || round > 0) {
            break;   // 普通回答;或总结轮不再执行新动作
        }

        final RkllmActionExecutor.ToolCall call = mActions.parse(calls.get(0));

        boolean approved = true;
        if (mActions.needsConfirmation(call.name)) {
            // 中风险动作:UI 线程弹窗,worker 用 CountDownLatch 等待
            approved = RkllmConfirmDialog.await(mContext, mWindowManager,
                    mActions.describe(call.name, call.args));
        }
        final RkllmActionExecutor.ToolResult result = approved
                ? mActions.execute(call)
                : new RkllmActionExecutor.ToolResult(false, "declined by user");

        turns.add(assistantMessage("[device action] " + call.name + " -> "
                + result.detail));
        // 回传结果让模型做总结;原始 tool_call 文本不重放,
        // 否则后续不带工具定义的请求里模型会照着模仿
        messages.put(assistantMessage(spoken.isEmpty()
                ? "[device action] " + call.name : spoken));
        messages.put(resultMessage(call, result));
    }
    rememberTurns(turns);
}
三条约束值得单独拎出来:
- 一轮只信第一个调用(
calls.get(0)),3B 模型不值得托付多步规划。 - 总结轮绝不执行新动作(
round > 0直接 break),哪怕模型又吐出一段<tool_call>。 - 第二轮不带
tools,服务端据此恢复纯聊天模板,模型只负责把执行结果说成人话。
4.4 SSE 读取与 StreamBuffer 分流
private StreamBuffer request(JSONArray messages, boolean withTools) throws Exception {
    final JSONObject body = new JSONObject();
    body.put("model", MODEL);
    body.put("messages", messages);
    body.put("stream", true);
    body.put("max_tokens", MAX_TOKENS);
    if (withTools) {
        body.put("tools", mActions.buildToolsJson());
    }
    // ... 此处省略 HttpURLConnection 建连与写 body

    final StreamBuffer buffer = new StreamBuffer();
    try (BufferedReader reader = new BufferedReader(new InputStreamReader(
            connection.getInputStream(), StandardCharsets.UTF_8))) {
        String line;
        while ((line = reader.readLine()) != null) {
            if (!line.startsWith("data: ")) {
                continue;
            }
            final String data = line.substring(6).trim();
            if ("[DONE]".equals(data)) {
                break;
            }
            final JSONObject chunk = new JSONObject(data);
            if (chunk.has("error")) {
                appendLog("\n" + mContext.getString(R.string.rkllm_chat_error)
                        + chunk.getJSONObject("error").optString("message") + "\n");
                break;
            }
            final JSONArray choices = chunk.optJSONArray("choices");
            if (choices == null || choices.length() == 0) {
                continue;
            }
            final JSONObject delta = choices.getJSONObject(0).optJSONObject("delta");
            if (delta != null) {
                final String content = delta.optString("content", "");
                if (!content.isEmpty()) {
                    buffer.append(content, display);
                }
            }
        }
    }
    buffer.finish(display);
    return buffer;
}模型输出里,普通文本和 <tool_call> 走的是同一条 SSE 通道,没有独立字段。StreamBuffer 用一个两态状态机把两者拆开:
| 字段 | 用途 |
|---|---|
mDisplay |
要显示在聊天区的文本 |
mToolCalls |
抽出的工具调用 JSON 列表 |
mRaw |
完整原文 |
mPending |
尚未判定的暂存文本(可能含半个标签) |
private void drain(Consumer<String> display) {
    // 一个 SSE chunk 里可能同时出现:正文 + 完整调用 + 又一段正文,甚至多个调用
    while (true) {
        if (!mInTool) {
            final int start = mPending.indexOf(OPEN);
            if (start >= 0) {
                if (start > 0) {
                    show(mPending.substring(0, start), display);
                }
                mPending.delete(0, start + OPEN.length());  // 丢掉开标签
                mInTool = true;                             // 切换到工具态
                continue;
            }
            holdBackPartial(OPEN, null, display);
            return;
        }
        final int end = mPending.indexOf(CLOSE);
        if (end >= 0) {
            mToolBody.append(mPending.substring(0, end));  // 闭合标签前即调用体
            mToolCalls.add(mToolBody.toString());
            mToolBody.setLength(0);
            mPending.delete(0, end + CLOSE.length());
            mInTool = false;
            continue;
        }
        holdBackPartial(CLOSE, mToolBody, null);
        return;
    }
}
4.5 标签被 SSE 撕成两半怎么办
模型输出是逐片段到达的,<tool_call> 可能被切在任何位置:
chunk1: ... 好的 <tool
chunk2: _call>{"name":"set_brightness"
chunk3: ,"arguments":{"value":150}}</tool
chunk4: _call>
holdBackPartial() 的做法是:从最长可能前缀往下试,找出尾部有多少字符「疑似标签开头」,先把确定安全的部分放行,只把这几字符留在 mPending 里等下一个 chunk。
// Emits everything except a possible trailing partial tag,
// so a tag split across two chunks is still recognised later.
private void holdBackPartial(String tag, StringBuilder collect,
        Consumer<String> display) {
    int hold = 0;
    final String text = mPending.toString();
    final int max = Math.min(text.length(), tag.length() - 1);
    for (int len = max; len > 0; len--) {
        if (text.regionMatches(text.length() - len, tag, 0, len)) {
            hold = len;   // 尾部 len 个字符 == 标签的前 len 个字符
            break;
        }
    }
    final int safe = mPending.length() - hold;
    if (safe <= 0) {
        return;
    }
    final String safeText = mPending.substring(0, safe);
    if (collect != null) {
        collect.append(safeText);      // 工具态:进调用体
    } else {
        show(safeText, display);      // 文本态:显示
    }
    mPending.delete(0, safe);         // 只留尾部 hold 个字符
}
最终解析出来的是一段普通 JSON 字符串:
[ "{\"name\":\"set_brightness\",\"arguments\":{\"value\":150}}" ]4.6 白名单执行 + 中风险二次确认
RkllmActionExecutor.execute() 不做动态反射,只认一张写死的 switch 白名单;wifi_toggle、bluetooth_toggle 这类会改变连接状态的操作,先弹窗确认:
public ToolResult execute(ToolCall call) {
    if (call == null) {
        return fail("malformed tool call");
    }
    try {
        switch (call.name) {
            case "open_app":          return openApp(call.args);
            case "set_brightness":    return setBrightness(call.args);
            case "set_volume":        return setVolume(call.args);
            case "open_settings":     return openSettings();
            case "go_home":           return goHome();
            case "go_back":           return goBack();
            case "wifi_toggle":       return wifiToggle(call.args);
            case "bluetooth_toggle":  return bluetoothToggle(call.args);
            case "get_volume":        return getVolume();
            case "get_battery":       return getBattery();
            case "open_app_by_name":  return openAppByName(call.args);
            default:                  return fail("unknown action: " + call.name);
        }
    } catch (SecurityException | IllegalArgumentException e) {
        return fail(call.name + ": " + e.getMessage());
    }
}
执行结果会以 tool 角色的结构化消息回传,服务端 BuildPrompt 把历史拼成 Conversation so far 转录,模型据此生成一句自然语言总结。
05 普通问答 vs 设备操作:一张表看清差异
| 环节 | 普通问答 | 设备操作 |
|---|---|---|
| 请求 Body | messages + stream:true + max_tokens |
同上,额外带 tools(11 个 function) |
| 服务端 | 不注册工具;若 handle 上还留着上次配置,先调 rkllm_set_chat_template(nullptr…) 恢复纯聊天模板 |
调 rkllm_set_function_tools(固定提示词, tools_json, "<tool_response>"),用 applied_tools_ 去重 |
| 系统提示词 | 模型默认 | 仅明确要求设备操作才调用,其它问题直接回答且不提及工具 |
| 模型输出 | 自然语言文本 | 自然语言,或 <tool_call>{json}</tool_call> 文本 |
| 上层处理 | 直接上屏 | 解析 → 白名单执行 → 结果回传 → 第二轮总结 |
06 多线程能更快吗
当前 HTTP 服务是单线程,处理速度偏慢,但 NPU 并没有吃满。能不能靠多线程提速?结论是:在当前配置下不能。
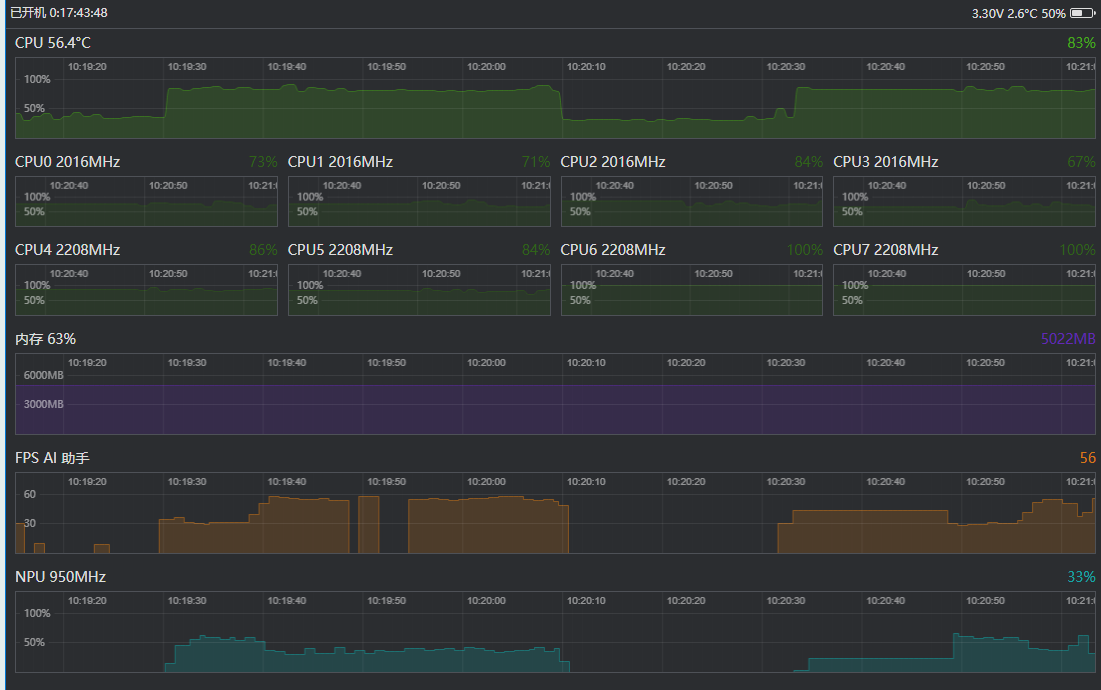
三个约束叠在一起:
- Engine 层只有一个 handle,而 handle 是有状态的。并发请求会抢同一份工具配置和推理上下文。
- 模型 W8A8 3B 加载后 RSS 约 3.4 GB。8 GB 的板子放两个实例已经接近极限。
num_npu_core = 2已把 NPU 两个核心占满。官方规格描述的是多核/多任务协同能力,但那是不同模型、不同任务在两个核心上各跑各的,不等于本方案可以在同一 handle 上并行。
横向对比一下真正能并行的方案:
| 方案 | 并行方式 | 并发上限受限于 |
|---|---|---|
| NVIDIA GPU + vLLM | 真并行、动态组批 | 显存 |
| Intel OpenVINO | 多流并行、自动组批 | CPU 核数与内存带宽 |
| 本文方案(RKLLM 单 handle) | 串行,一次一个请求 | 单个 handle + NPU 核心数 |
要真正提升并发,前提是改成多实例(多 handle)并重新分配 NPU 核心,代价是接近翻倍的内存占用。这已经超出本文范围。
07 小结
把整条链路收成四步:
- BSP 层:一个 vendor 模块把运行时、服务、配置打包,
inherit-product一行接入;3.6 GiB 模型放/data,不进镜像;服务由属性开关拉起,只监听127.0.0.1:8080。 - Native 服务层:一个手搓的 socket +
select服务,把/v1/chat/completions翻译成rkllm_run,用TextSink统一非流式与流式输出。 - Engine 层:
dlopen解析 C API,后台加载模型,工具定义挂在 handle 上并用状态机切换,worker 线程跑同步推理,断连时rkllm_abort。 - SystemUI 层:先判意图再决定是否带工具,SSE 里的
<tool_call>由StreamBuffer状态机拆出,白名单执行 + 中风险确认,最后把结果回传给模型做一句总结。
三个我认为最值得记住的设计取舍:
- 小模型要靠工程约束兜底:意图前置判断、一轮一次调用、总结轮禁用动作、白名单执行——这四条都不是模型能力,是上层替它兜的底。
- 配置持久化是隐形陷阱:
set_function_tools挂在 handle 上,普通问答必须显式恢复纯聊天模板,否则上一条请求会污染下一条。 - 服务端只透传、不解析:
<tool_call>一路原样到客户端,职责边界清晰,代价是客户端要自己处理 SSE 分片撕标签。
本文聚焦框架与调用链。性能测试数据、多实例并发的方案取舍,留到下一篇。